~/videotext/training
Trainingslauf
Zwei Stufen gemessen: Der Deskriptor (Stufe A) stößt an seine Grenze, der Klassifikator je Zeichenposition (Stufe B) liest ungesehene Kennungen — inklusive der Stufen, an denen beide scheitern. ( Full-Stack · Data Science · ML/KI · Cybersicherheit · Design · Open Source )
Kontakt aufnehmen
Stand des Laufs
Der Lauf ist beendet. Alle Messzahlen auf dieser Seite stammen aus den Laufdateien und wurden beim Build eingefroren — Status, Runde und Stand stehen deshalb nebeneinander, nicht im Kleingedruckten.
Der Datensatz
72 Referenzbilder aus 12 Markierungen, 6 Stufen. Jedes Bild trägt seine Erzeugungsparameter als eigene Spalte —25 Felder, damit jeder Fehler einer Ursache zugeordnet werden kann statt nur „schlecht erkannt“ zu heißen.
| Stufe | Klasse | Bilder |
|---|---|---|
| 0 | Reinzeichnung | 12 |
| 1 | Perspektive / Drehung | 12 |
| 2 | Unschärfe / Bewegung | 12 |
| 3 | Reel-Kompression | 12 |
| 4 | Licht / Glanz | 12 |
| 5 | Klein im Bild / verdeckt | 12 |
Stufe 6–10 sind in der Leiter definiert, liegen aber nicht als Referenzsatz auf der Platte: Der Lauf erzeugt sie beim Einbetten neu. Stufe 10 hat zusätzlich noch keinen eigenen Zweig — sie durchläuft derzeit dieselben Schritte wie Stufe 9.
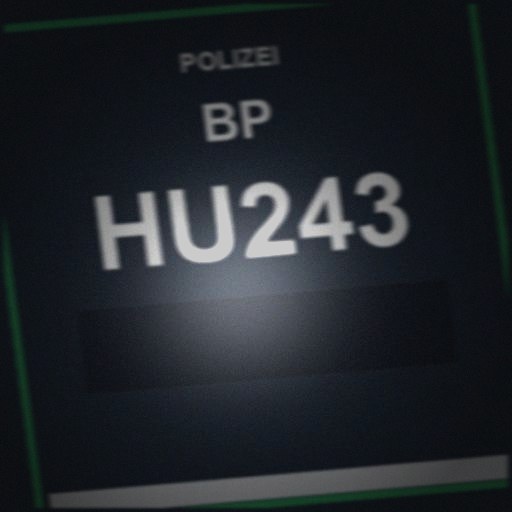
BP HU243
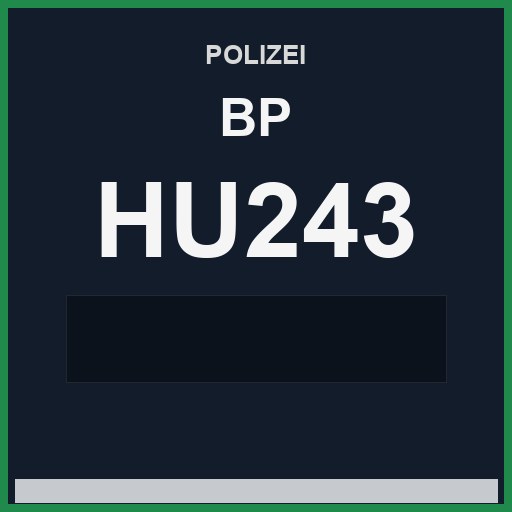
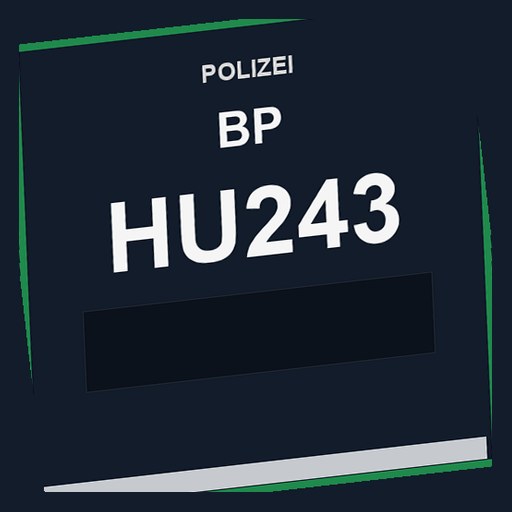
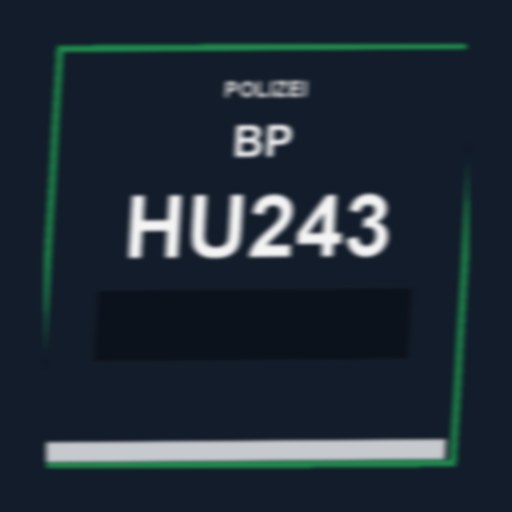
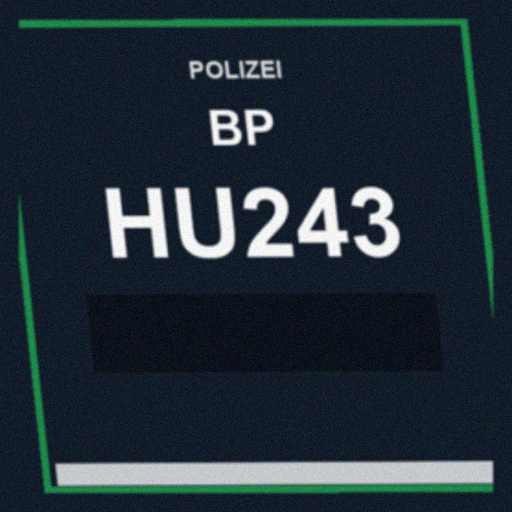
BE 1321W
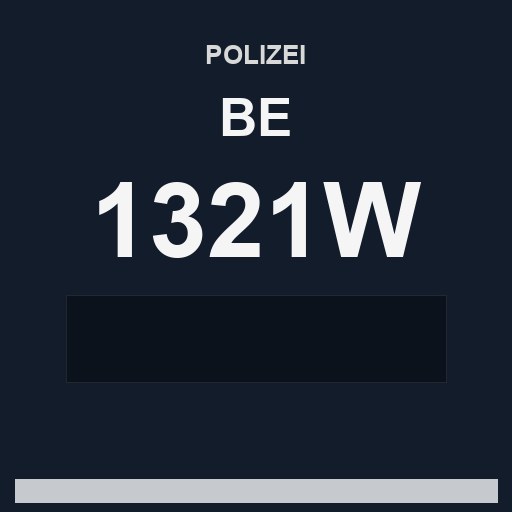
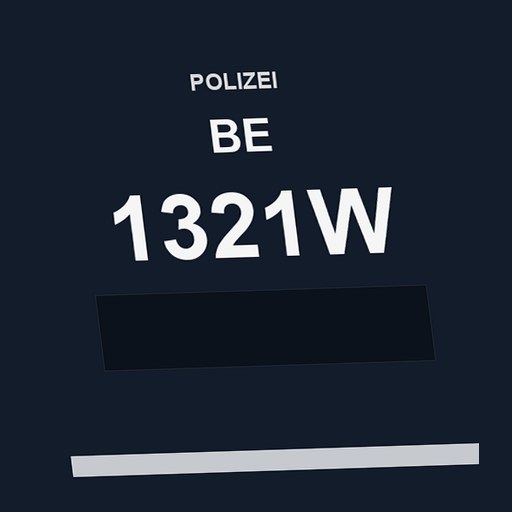
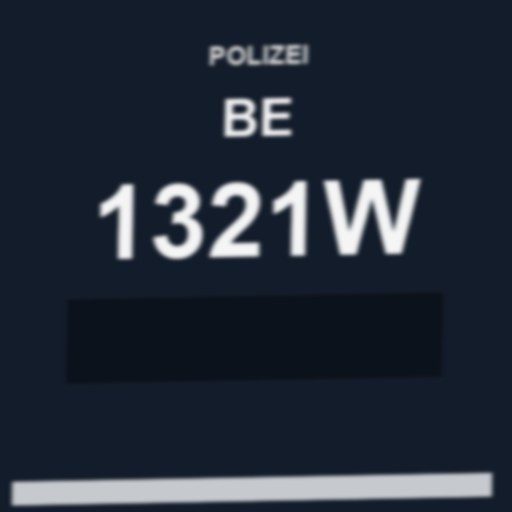
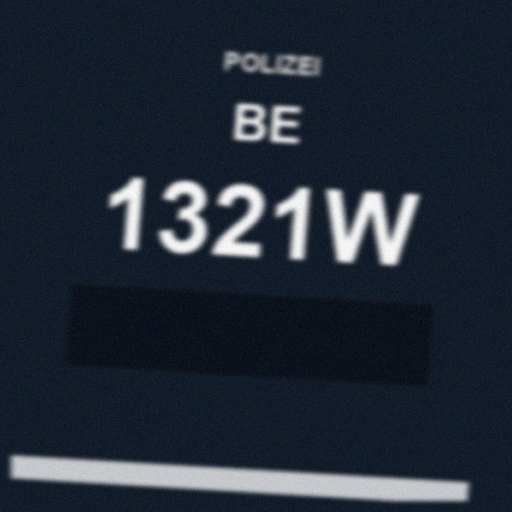
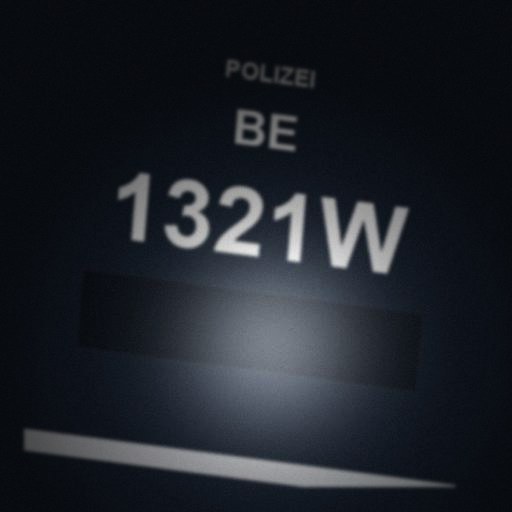
Dieselbe Markierung über alle sechs Referenzstufen. Die Bilder sind synthetisch und exakt gelabelt; die Bilddatei heißt wie ihre Zeile in out/labels.csv.
Der Deskriptor
Bevor irgendetwas verglichen wird, wird ein Kennzeichen zu 141 Zahlen. Die wichtigste Entscheidung dabei ist der Zuschnitt: nicht das 20×20-cm-Feld, sondern die obere Zone, in der Land und Einheit stehen.
| Block | Größe | Zweck |
|---|---|---|
| Zuschnitt | 26–64 % der Höhe | Markierungszone statt ganzem Feld |
| Graustufen-Raster | 40 × 16 | Grundlage der Gradienten |
| Gradientenzellen |gx| und |gy| | 2 × 30 | Kanten statt absoluter Helligkeit |
| Projektionsprofile | 39 + 15, × 1,5 | Position der Zeichen |
| Farbgitter | 3 × 3 × 3, × 0,25 | Zugfarbe und Material |
| Normierung | L2 = 1 | Kosinus wird zum Skalarprodukt |
| DCT-Gate | 63 Bit | Vorfilter gegen Unschärfe und Kompression |
| Summe | 141 Dimensionen | ein Vektor je Kennzeichen |
- Ein Thumbnail des ganzen Feldes ist bei allen Kennzeichen fast identisch: gleiches Layout, gleicher Reflexstreifen, dieselbe Grundfarbe. Die Ziffern sind darin nur wenige Pixel.
- Die Projektionsprofile sind der Teil, der Position erhält — ohne sie liegen zwei Kennungen mit gleicher Ziffernzahl fast übereinander.
- Der DCT-Hash entscheidet nicht über die Klasse. Er ist ein Vorfilter: erst wenn die Hashes nah beieinander liegen, wird der Vektor überhaupt verglichen.
- Das Studio im Browser rechnet mit einer kleineren Variante (16×16-Thumbnail, gleiches Farbgitter, gleicher DCT-Gate). Gemeinsam ist das Prinzip, nicht die Bitgleichheit.
Die Stufenleiter
11 Stufen, kumulativ angewendet. Das Label bleibt gleich — nur die Pixel ändern sich. Damit lässt sich ein Fehler einer Ursache zuordnen: Geometrie, Fokus, Codec, Licht, Maßstab, Bildschirm, Überlagerung, Sensor.
| Stufe | Klasse | Was dazukommt |
|---|---|---|
| 0 | Reinzeichnung | Referenzbild ohne Degradation |
| 1 | Perspektive / Drehung | Drehung ±12°, Scherung ±0,15, Skalierung 0,8–1,0 |
| 2 | Unschärfe / Bewegung | Gauß 0,8–2,0 px, in der Hälfte der Fälle Bewegungsunschärfe |
| 3 | Reel-Kompression | JPEG q35–70, Downscale 0,45–0,8, Sensorrauschen |
| 4 | Licht / Glanz | Helligkeit, Glanz, Vignette |
| 5 | Klein im Bild / verdeckt | Kennzeichen klein im Bild, teilweise verdeckt |
| 6 | Screen-Capture (Moiré, Subpixel) | Bildschirmaufnahme: Moiré, Subpixel-Muster |
| 7 | Überlagerung / Okklusion | Zusätzliche Überlagerung / Okklusion |
| 8 | IR / Gegenlicht / Rolling Shutter | IR, Gegenlicht, Rolling Shutter |
| 9 | Adversarial (JPEG<25, 3x Downscale, Kantenrauschen) | JPEG unter 25, dreifaches Downscale, Kantenrauschen |
| 10 | Anti-Bot (Kombination + Jitter + Dekoys) | kein eigener Zweig — entspricht derzeit Stufe 9 |
_scene (Stufe 5) wird nach den Stufen 8 und 9 angewendet. Wer die Leiter nachbaut, muss diese Reihenfolge übernehmen, sonst entstehen andere Bilder als die, auf denen die Kurve beruht.Die Lernkurve
Jede Runde erzeugt Trainings-Embeddings aus Stufe 0–2 und Prüf-Embeddings aus Stufe 3–10, vergleicht sie gegen die Bibliothek und protokolliert den besten Kandidaten. Die Kurve zeigt diesen besten Kandidaten je Runde.
●

 ●●● ●   ●●   ● ● ● ●●● ●●●
    ● ●●●  ●●● ● ● ●   ●   ●
28 Abschnitte über 353 Runden, Mittel je Abschnitt · y-Achse relativ zum Maximum der Abschnitte (4,26 %) · links Runde 1, rechts Runde 353
| Fenster | Runden | exact | Präzision | Abstention |
|---|---|---|---|---|
| R1–10 | 10 | 5,10 % | 8,23 % | 38,00 % |
| R11–50 | 40 | 1,70 % | 2,74 % | 37,87 % |
| R51–150 | 100 | 1,55 % | 2,49 % | 37,86 % |
| R151–250 | 100 | 1,54 % | 2,47 % | 37,87 % |
| R251–350 | 100 | 1,66 % | 2,66 % | 37,82 % |
| R351–353 | 3 | 1,39 % | 2,23 % | 37,92 % |
exact ist der Anteil richtiger Antworten an allen Prüf-Embeddings; eine Abstention zählt dabei als Fehler. Präzision zählt nur die beantworteten Fälle, Abstention den Rest.
Je Stufe
Mittel der letzten 20 Runden, aufgeschlüsselt nach Prüfstufe. Die Erwartung war ein gleichmäßiges Gefälle; tatsächlich bricht die Kurve zwischen Stufe 3 und 5 und liegt danach flach.
| Stufe | Klasse | exact (letzte 20 Runden) |
|---|---|---|
| 3 | Reel-Kompression | 5,42 % |
| 4 | Licht / Glanz | 4,50 % |
| 5 | Klein im Bild / verdeckt | 1,17 % |
| 6 | Screen-Capture (Moiré, Subpixel) | 1,33 % |
| 7 | Überlagerung / Okklusion | 1,42 % |
| 8 | IR / Gegenlicht / Rolling Shutter | 0,00 % |
| 9 | Adversarial (JPEG<25, 3x Downscale, Kantenrauschen) | 0,00 % |
| 10 | Anti-Bot (Kombination + Jitter + Dekoys) | 0,00 % |
Letzte Runde 353 (12.11.2026, 17:11 Uhr): 1,04 % exact, 1,69 % Präzision, 38,33 % Abstention. Die Beziehung ist keine zweite Messung, sondern dieselbe Zahl anders gerechnet: (61,7 % beantwortet) × 1,69 % = 1,04 % — die Abweichung in der letzten Stelle stammt aus der Rundung der Laufdatei.
- Stufe 3 (Reel-Kompression) trägt den Rest: Der Deskriptor überlebt JPEG, aber nicht die Verwechslung mit einer anderen Kennung.
- Stufe 8, 9, 10 stehen in jeder abgeschlossenen Runde bei 0,00 %. Kein Prüfbild dieser Stufen wurde je getroffen — nicht weil die Stufen zu schwer sind, sondern weil davor schon alles verwechselt wird.
- Die Abstention bleibt über alle Runden bei rund 38 %. Die Schwelle 0,80 trennt nicht zwischen sicher und unsicher; sie schneidet eine Ähnlichkeitsverteilung, die für alle Kennzeichen ähnlich aussieht.
Warum es stehen bleibt
Vier Ursachen, alle in den Laufdaten nachweisbar. Keine davon lässt sich durch mehr Runden beheben — deshalb ist Stufe A an dieser Stelle zu Ende.
- 01
Der Deskriptor ist global
Ein Vektor für das ganze Kennzeichen. Zwei Kennungen mit gleicher Ziffernzahl liegen fast überall nah beieinander; die eine abweichende Stelle bewegt den Vektor kaum.
- 02
Die Bibliothek wächst, die Trennschärfe nicht
Ab Runde 13 liegen 2.000 Markierungen im Training. Jede zusätzliche wird ein möglicher falscher Nachbar, ohne dass der Deskriptor besser unterscheidet.
- 03
Die Schwelle trennt nicht
0,80 ist kein Sicherheitsmaß: Fast jeder Nachbar liegt darüber, also antwortet das System bei rund 62 % der Bilder — und liegt dabei fast immer falsch. Die Abstention bleibt konstant.
- 04
Das Kalibrierziel ist unerreichbar
Der Lauf sucht eine Schwelle mit mindestens 99 % Präzision. In 353 Runden wurde sie nie erreicht; die höchste je gemessene Präzision liegt bei 18,12 %.
Stufe B: pro Stelle statt pro Kennzeichen
Stufe B ist gebaut und gemessen: kein Vektor für die ganze Kennung, sondern ein Klassifikator je Zeichenposition, jeder nur auf die Zeichen beschränkt, die diese Stelle legal tragen kann. Auf ungesehenen Kennungen erreicht das Modell im Schnitt 99,2 % Zeichen (schlechtester Wert 97,7 %); Stufe A liegt bei 17,2 % über alle Stufen zusammen.
| Stufe | Zeichen | Top-2 | ganze Zeichenkette |
|---|---|---|---|
| L3 · Reel-Kompression | 97,7 % | 99,2 % | 88,8 % |
| L4 · Licht / Glanz | 98,4 % | 99,7 % | 92,1 % |
| L5 · Klein im Bild / verdeckt | 100,0 % | 100,0 % | 100,0 % |
| L6 · Screen-Capture (Moiré, Subpixel) | 100,0 % | 100,0 % | 100,0 % |
| L7 · Überlagerung / Okklusion | 99,8 % | 100,0 % | 98,7 % |
| L8 · IR / Gegenlicht / Rolling Shutter | 99,9 % | 100,0 % | 99,2 % |
| L9 · Adversarial (JPEG<25, 3x Downscale, Kantenrauschen) | 99,1 % | 99,7 % | 95,9 % |
| L10 · Anti-Bot (Kombination + Jitter + Dekoys) | 98,5 % | 99,8 % | 92,6 % |
| Mehrheitslinie | 16,2 % | — | — |
| Stufe A (Deskriptor) | 17,2 % | — | 0,0 % |
- 7 Prüf-Kennungen waren zufällig auch im Training und wurden entfernt, nicht als Treffer gezählt.
- 50 % der Trainingszellen laufen invertiert durch das Netz — ohne das bricht die Kette an Stufe 8 (IR/Gegenlicht) auf Zufallsniveau ein.
- Die Positions-Alphabete sind der größte einzelne Gewinn: Stelle 4 hat drei zulässige Zeichen, Stelle 1 elf — nicht 36 überall.
- Im Studio läuft Stufe B seit dem 15.11.2026 als Zweitmeinung: Die Zellen kommen aus der erkannten Zeile, nicht aus der Render-Geometrie. Sie zählt deshalb nur, wenn sie die Grammatik besteht und mindestens 88 % Konfidenz erreicht — sonst bleibt die OCR-Lesung.
- Die Seeds sind deterministisch; derselbe Aufruf liefert dieselben Zahlen.
Der Unterschied ist rechenbar, ohne ein Modell zu behaupten: Wähle zwei echte Kennungen aus dem Korpus und vergleiche, was ein Ganzzeichen-Vergleich sieht und was ein Stellenvergleich sieht.
| Stelle | A | B | Treffer |
|---|---|---|---|
| 1 | H | 1 | verschieden |
| 2 | U | 3 | verschieden |
| 3 | 2 | 2 | gleich |
| 4 | 4 | 1 | verschieden |
| 5 | 3 | W | verschieden |
1 von 5 Stellen stimmt überein. Ganzzeichen-Vergleich: ein Treffer zählt nur, wenn die komplette Nummer stimmt, also 0. Stellenweise: 1 Treffer; an 4 Stellen entscheidet jeweils ein 37-Klassen-Problem statt eines Vergleichs gegen den ganzen Bibliotheksbestand.
- Berlin und die Bundespolizei sind fünfstellig. Andere Länder haben drei bis fünf Zeichen; dort braucht es eine Segmentierung oder ein definiertes Padding, sonst wandert die Stelle.
- Die Köder sind Pflicht: Ein Klassifikator, der nur Kennzeichen sieht, antwortet auch auf Briefkästen — nur falsch.
- Die Seeds bleiben deterministisch, damit derselbe Lauf dieselben Zahlen liefert.
- Die Artefakte dieses Projekts bleiben deutschsprachig.
Nachvollziehen
Alles, was diese Seite zeigt, liegt im Repository. Ein Befehl startet den Lauf, einer zeigt den Stand, einer beendet ihn.
./start-training.sh              # Lauf starten
./start-training.sh --status     # Stand anzeigen
./start-training.sh --stop       # Lauf beenden
npm run km:gen                    # diese Seite neu aus den Laufdateien bauen
| Datei | Inhalt |
|---|---|
| out/night/results.json | 353 Runden, je 4 Kandidaten plus Kalibrierung |
| out/night/status.json | laufende Runde, Phase, Schritt — die Quelle für den Status oben |
| out/labels.csv | 72 Zeilen, 25 Spalten Erzeugungsparameter |
| out/level-0 … level-5 | je 12 Referenzbilder pro Stufe |
| augment.py | Stufenleiter und kumulative Anwendung |
| embedding.py | Deskriptor und DCT-Gate |
Diese Seite und das Studio lesen dasselbe Modul (src/lib/kennzeichen-ml.ts). Es gibt keine zweite Zahlenquelle und keine von Hand eingetragene Kurve.
Zurück zum Studio
Die Erkennung im Browser, der Datensatz-Generator und das Nachschlagewerk stehen auf der Studio-Seite.